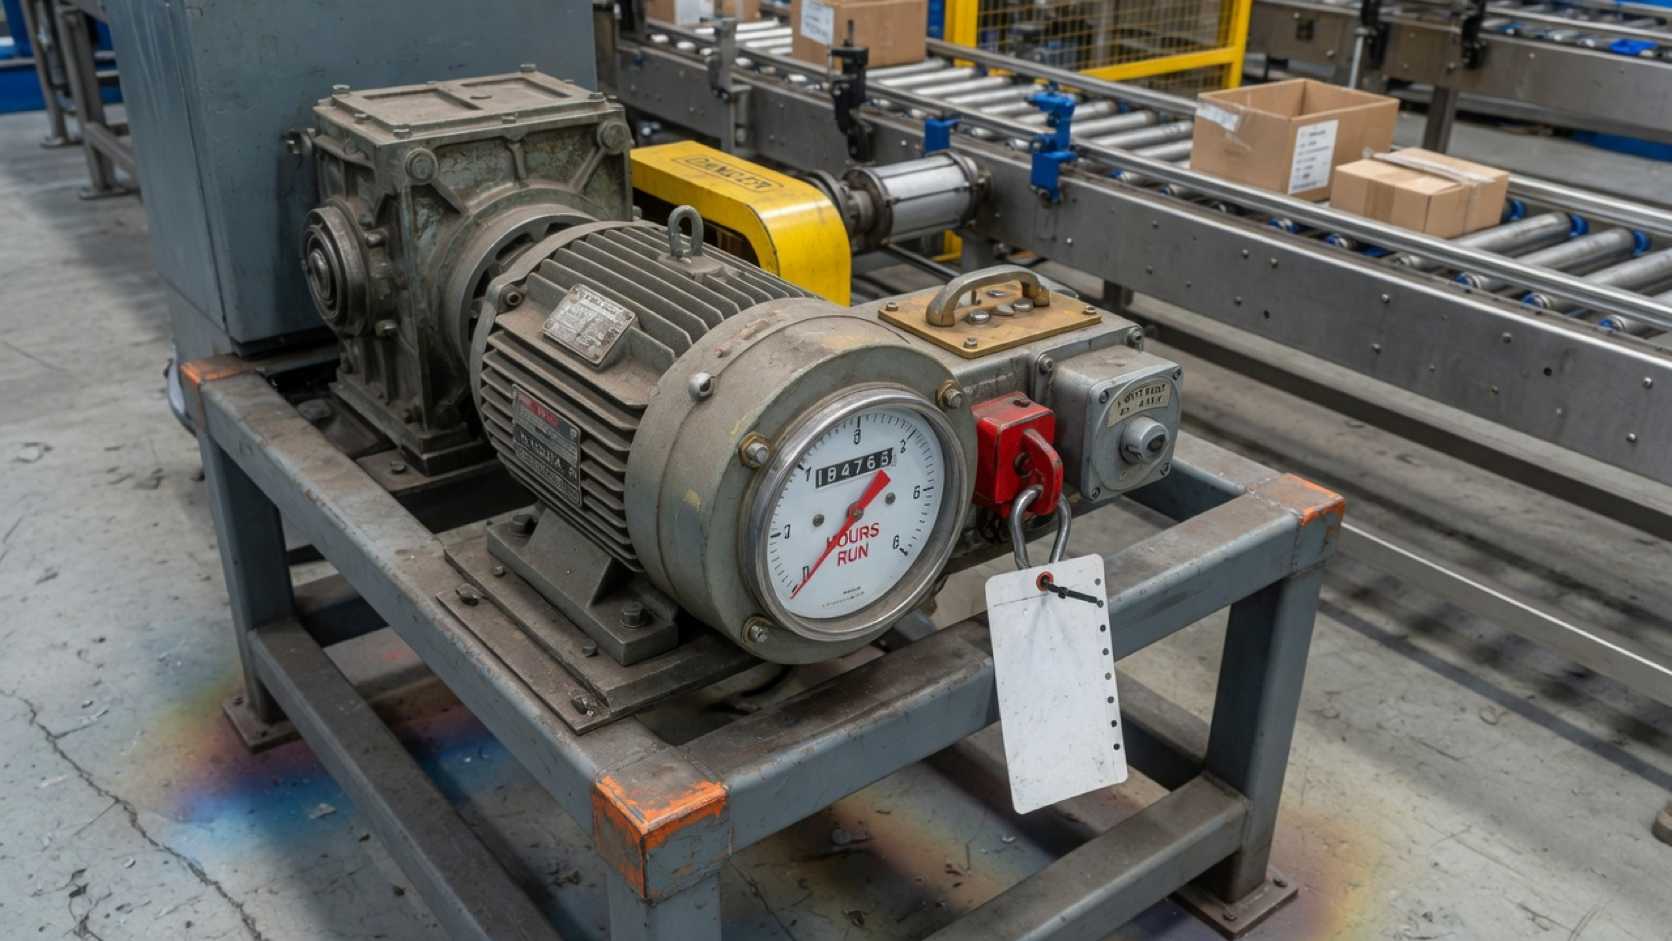
En planta, «MTBF» suele llegar como una sola cifra y una pregunta torcida: «entonces, ¿cada cuánto falla de verdad?». La cifra puede ayudar. Leída como cuenta atrás para un solo motor o reductor, esa pregunta no es la que responde el indicador.
El Mean Time Between Failures (tiempo medio entre fallos) resume, para una población y una ventana declaradas, la exposición acumulada dividida por los fallos que cumplen la regla de recuento. NIST/SEMATECH lo estima como tiempo total de operación entre número total de fallos bajo el modelo de tasa constante. NIST e-Handbook, §8.4.5.1
NASA ilustra el mismo cociente con horas de operación y fallos observados en su guía de mantenimiento centrado en fiabilidad. Guía RCM de la NASA
No reescribo aquí la ficha de catálogo del fabricante ni un tutorial de Weibull. Eso ya tiene páginas propias: qué es MTBF y cómo interpretar el MTBF. La frontera de este artículo es más estrecha: qué pregunta contesta el número en el pasillo, qué horas y qué fallos deben quedar escritos, y cuándo la media deja de ser comparable o deja de bastar.
Los ejemplos numéricos son hipotéticos o tomados de las fuentes citadas. No describen tu planta ni un ROI. WizeeMind reúne evidencia operativa con fuente, hora y límite de activo; no calcula el MTBF oficial de la planta. Si el siguiente paso es humano, hablemos.
Qué pregunta contesta el MTBF
El MTBF, en su lectura operativa habitual, dice cuántas horas de exposición se observaron por cada fallo cualificado en un conjunto definido. No dice «¿cuándo fallará esta unidad?» ni «¿es seguro dejarlo correr hasta esa cifra?».
NIST formula la estimación bajo el modelo HPP/exponencial: MTBF estimado = tiempo total de operación de los sistemas (o unidades) ÷ número total de fallos. NIST e-Handbook, §8.4.5.1
NASA, en §5.5.5.2, expresa la tasa de fallos como número de fallos entre horas totales de operación e invierte esa tasa para obtener el MTBF bajo el supuesto exponencial del ejemplo. Guía RCM de la NASA
El resultado es un promedio de lo observado. Si cinco unidades aportan horas y fallos a la misma cuenta, describes el conjunto, no el destino de la unidad número tres. Siemens, en un manual de fuente de alimentación, lo deja escrito: el número MTBF es una indicación estadística de probabilidad de fallo y no representa necesariamente la vida útil del producto. Manual Siemens 8US, §11
Hay un detalle del supuesto de tasa constante que se pierde en muchas reuniones. NASA indica que, con tasa constante, la fiabilidad en la vida media es aproximadamente 0,37: un 37 % de probabilidad de sobrevivir a esa vida media sin fallo. Guía RCM de la NASA, §5.5.5.1 Leer «761 h de MTBF» como «falla a las 761 h» choca con esa lectura.
En planta la pregunta útil es más estrecha: «en esta población, con estas horas y esta regla de fallo, ¿qué media observamos?». Eso orienta tendencias, periodos homogéneos y la conversación con producción sobre exposición. No sustituye el análisis de un modo de fallo concreto ni la decisión de consignar un equipo.
SAE JA1011 sitúa el mantenimiento centrado en fiabilidad como criterio de evaluación para organizaciones que gestionan activos físicos o sistemas. SAE JA1011_202411 El MTBF puede alimentar esa conversación. Por sí solo no es un proceso RCM completo ni un veredicto de estrategia.
Cuando alguien pide «el MTBF del ventilador 12», suele mezclar tres peticiones: el historial de esa unidad, la media de una familia y una predicción. Conviene separarlas. El historial puede listar intervalos entre eventos. La media de familia es el cociente agregado. La predicción exige otro modelo y otras evidencias. Meter las tres bajo el mismo acrónimo convierte un indicador honesto en una falsa cuenta atrás.
Para la tasa asociada al cociente, tasa de fallos ordena la lectura inversa. Aquí basta con no tratar el MTBF como reloj individual.
Horas de marcha frente a horas de calendario
El numerador decide la pregunta. Horas de marcha entre fallos dan horas de marcha por fallo observado. Horas de calendario entre fallos dan otra magnitud: tiempo transcurrido por evento, no exposición de operación.
El ejemplo de NASA usa «Total Operating Hours» y fallos en horas de operación, no días de calendario del mes. Guía RCM de la NASA, tablas 5-6 y 5-7 NIST habla de «Total System(s) operation time» en el estimador del MTBF. NIST e-Handbook, §8.4.5.1
Imagina un escenario hipotético. El activo A acumula 360 h de marcha en un mes y registra un fallo cualificado. El activo B acumula 180 h y también un fallo. Con horas de marcha, los cocientes son 360 h y 180 h por fallo. Si alguien fuerza 720 h de calendario para ambos, iguala los resultados y responde a otra pregunta. Los números son inventados para mostrar el efecto del numerador; no describen una planta real.
El contador de horas de marcha no gana siempre por defecto. Encaja cuando la pregunta es fiabilidad en servicio. Un equipo que apenas arranca puede acumular pocos fallos y pocas horas mientras el calendario sigue. Uno en tres turnos acumula exposición más rápido. Compararlos con el mismo reloj de pared distorsiona la media.
Declara también qué cuenta como marcha. ¿Horas con producto? ¿Horas energizado? ¿Horas por encima de una velocidad mínima? Sin esa nota, dos turnos pueden rellenar el mismo campo GMAO con criterios distintos.
NIST distingue sistemas reparables (donde interesa la tasa de ocurrencia de fallos o tasa de reparación) de poblaciones no reparables (donde los modelos de vida hablan del primer fallo). NIST e-Handbook, §8.1.2.1
En planta industrial la mayor parte de activos de proceso son reparables: vuelven al servicio. Por eso conviene medir exposición de operación entre eventos, no solo días entre órdenes.
Siemens publica tablas MTBF ligadas a corriente y temperatura ambiente, y cita métodos SN 29500 / IEC 61709 y MIL HDBK 217F. Manual Siemens 8US, §11 Esas condiciones de catálogo no son tu sala de cuadros. Sirven de contraste: incluso el fabricante ancla el número a un perfil térmico y de carga. Tu informe de planta debe anclar el suyo a horas efectivas y régimen observado.
Una ficha mínima puede llevar dos relojes a la vez: fechas de la ventana (calendario) y horas de marcha acumuladas (exposición). Así quien lee sabe el periodo y la base del cociente. Si solo tienes fechas de alta y cierre de orden, no llames «horas de marcha» a la resta entre ambas sin demostrar que el equipo estuvo operando.
Cuando produzcas el número para dirección, escribe la unidad completa: «horas de marcha por fallo cualificado», no solo «800 horas». Esa etiqueta corta evita que alguien lo lea como días de calendario hasta la próxima avería. Para el encaje con disponibilidad y tiempos de reparación, MTBF, MTTR y disponibilidad separa esas piezas sin mezclar relojes.
Qué cuenta como fallo
El denominador parece simple hasta que abres el GMAO. Una alarma, una parada, una orden correctiva y un aviso duplicado pueden describir el mismo incidente o cuatro cosas distintas. El MTBF solo es interpretable si la regla de inclusión queda escrita.
NASA indica que el MTBF debe calcularse a partir de historial de maquinaria en el CMMS y otras fuentes (registros de operador, uso de piezas, contratistas). Guía RCM de la NASA, §5.5.5.1 No impone tu taxonomía local. Sí recuerda que el dato sale de registros, no de intuición de pasillo.
NIST estima el MTBF con el número total de fallos en el periodo de observación. NIST e-Handbook, §8.4.5.1 Si tu extracto cuenta «todas las órdenes correctivas» y otra planta cuenta «solo pérdida de función requerida», los cocientes no hablan el mismo idioma aunque ambos digan MTBF.
Una regla operativa puede responder, por escrito, a preguntas concretas:
- ¿Qué evento pierde la función requerida?
- ¿Se cuenta cada aviso o cada incidente consolidado?
- ¿Cómo se tratan duplicados y reaperturas?
- ¿Entran fallos detectados en prueba o solo en servicio?
- ¿Qué ocurre con eventos abiertos al cerrar la ventana?
No copies una lista ajena como norma. Adapta la regla a tu sistema de códigos y déjala visible junto al número. Si la regla cambia tras una migración de GMAO, anota la fecha del cambio. Una serie «antes/después» puede mezclar comportamiento del equipo con comportamiento del registro.
NASA distingue MTBF (asociado a fallos) de MTBM (mean time between maintenance), que incluye acciones correctivas y preventivas. Guía RCM de la NASA, §14.3 Si metes preventivos en el denominador y sigues llamando al resultado MTBF, has cambiado de indicador. La disponibilidad operacional en esa sección se expresa con MTBM y tiempo medio caído, no sustituyendo etiquetas a conveniencia.
HSE recuerda que el mantenimiento de equipos de trabajo debe planificarse y ejecutarse de forma segura, y que un programa eficaz hace el equipo más fiable; también advierte que un mantenimiento inseguro ha causado lesiones graves. HSE, Maintenance of work equipment No define tu código de fallo. Sí marca otra frontera: clasificar mal un evento en el indicador no autoriza improvisar el trabajo de reparación.
Ejemplo hipotético: durante una ventana inventada hay seis órdenes correctivas y dos preventivas. Una cuenta de MTBF con los seis fallos no es intercambiable con una cuenta de MTBM con ocho acciones. Responden a recuentos distintos. Etiquétalos aparte.
Si el debate es predictivo frente a preventivo o correctivo, la elección de estrategia no se decide solo con el denominador del MTBF. Esa matriz está en predictivo, preventivo o correctivo. Aquí el punto es más corto: sin regla de fallo, la media es un número huérfano.
Por qué una media «buena» puede esconder racimos de fallos
Una media comprime la historia. Dos poblaciones pueden compartir el mismo MTBF y repartir los fallos de forma muy distinta: unos espaciados, otros en racimo. El cociente no enseña esa dispersión.
NIST describe la curva de la bañera: periodo temprano de tasa alta decreciente, tramo intrínseco más o menos plano y, si el uso se prolonga, desgaste con tasa creciente. NIST e-Handbook, §8.1.2.4
NASA, al asumir exponencial en su ejemplo, sitúa el cálculo en un régimen de tasa relativamente constante para un sistema maduro, fuera de mortalidad infantil y antes del desgaste. Guía RCM de la NASA, §5.5.5.2
Si los fallos se agrupan tras cambios de formato, arranques en frío o una campaña concreta, la media del trimestre puede verse «aceptable» mientras producción arrastra tres semanas malas. El indicador no miente; resume. Quien solo mira el resumen pierde el racimo.
Con pocos fallos, el número puntual engaña más de lo que parece. NIST pone un ejemplo con 800 h de operación y 2 fallos: MTBF estimado de 400 h, e intervalo de confianza al 90 % entre 127 y 2.251 h. NIST e-Handbook, §8.4.5.1 Con r = 0 solo existe un límite inferior unilateral. Una media «bonita» con dos eventos no cierra el debate.
Siemens ilustra la lectura poblacional con un ejemplo numérico de catálogo: un MTBF de 1.000.000 h significa, estadísticamente, que fallará una unidad cada 100 h si hay 10.000 unidades instaladas; no dice si la unidad fallida llevaba 50.000 h o solo 100 h. Manual Siemens 8US, §11 Traduce eso a planta: una media familiar alta puede convivir con un activo concreto que ya va por su tercer evento del mes.
Cuando sospeches racimos, baja al listado de intervalos, no discutas solo el promedio. Ordena fechas, turnos, producto, estado de marcha y trabajos recientes. El análisis de paradas con evidencia operativa ayuda a no cerrar la historia con el código más cómodo; ver análisis de paradas con evidencia operativa.
Douglas Thomas, en NIST AMS 100-18, examina costes y pérdidas de mantenimiento (directos, paradas, defectos) y la necesidad de datos para separarlos entre enfoques. NIST AMS 100-18 Un MTBF «bueno» no demuestra por sí solo que los costes de parada hayan bajado. Puede ocultar un racimo caro compensado por largos tramos sin eventos en otros activos del mismo saco.
Junto al MTBF del periodo, publica el número de fallos, las horas acumuladas y, si el recuento es pequeño, un aviso de incertidumbre. No hace falta un tutorial estadístico en el panel. Sí hace falta impedir que cinco eventos repartidos de forma desigual se vendan como estabilidad uniforme.
Cuándo comparar dos cifras
Comparar dos MTBF sin ficha es el atajo habitual de la reunión. Dos números iguales no prueban condiciones iguales. Dos números distintos tampoco demuestran, solos, que una línea sea «mejor».
Antes de ponerlos en la misma tabla, alinea al menos población (qué identificadores entran y cuáles se excluyen), tipo de horas (marcha, energizado, calendario u otro), ventana (fechas y régimen), regla de fallo con tratamiento de duplicados, y si el conjunto es reparable y qué se hizo tras cada evento.
Bajo el modelo descrito, NIST estima el MTBF igual con datos censurados o completos, pero el intervalo de confianza depende del número de fallos. NIST e-Handbook, §8.4.5.1 Comparar un periodo con 2 fallos frente a otro con 40 sin mirar la incertidumbre es teatro de precisión.
El ejemplo didáctico de NASA usa 3.805 h totales y 5 fallos: 761 h de MTBF bajo el supuesto exponencial. Guía RCM de la NASA, §5.5.5.2 Si citas «761» sin las 3.805 h, los cinco fallos y el supuesto, pierdes el contexto que la propia guía mantiene junto al número.
Siemens muestra cómo cambia la cifra de catálogo al cambiar temperatura, corriente y método (IEC 61709 / SN 29500 frente a MIL HDBK 217F con clases ambientales distintas). Manual Siemens 8US, §11 Esa sensibilidad de condiciones vale como advertencia para planta: si el periodo B añadió un tercer turno o cambió de producto abrasivo, no compares a ciegas con el periodo A.
Ejemplo hipotético de falsa equivalencia: conjunto A con 2.400 h y 4 fallos (600 h/fallo); conjunto B con 3.600 h y 6 fallos (también 600 h/fallo). Los cocientes coinciden. Sin saber carga, composición del grupo y regla de registro, la coincidencia no prueba equivalencia de fiabilidad.
SAE JA1011 ofrece criterios para evaluar procesos RCM en organizaciones que gestionan activos físicos. SAE JA1011_202411 Comparar MTBF puede ser un input de esa gestión. No sustituye definir funciones, modos de fallo y consecuencias.
Si la comparación cruza fabricante y planta, recuerda la frontera de qué es MTBF: el catálogo habla de producto y condiciones declaradas; el historial habla de lo registrado en tu ventana. Una diferencia entre ambos no fecha, por sí sola, el próximo fallo de una unidad.
Cuando la comparación sea interna (línea 1 frente a línea 2, o trimestre frente a trimestre), deja por escrito qué cambió en captura de datos. Un «MTBF mejor» tras formar a los técnicos para consolidar avisos puede ser un cambio de denominador, no de mecánica.
Límites: no predice la próxima avería ni acredita seguridad
El MTBF no funciona como temporizador. Tampoco acredita que un activo sea seguro, ni demuestra que una estrategia de mantenimiento haya funcionado, ni sustituye consignación, competencia o procedimientos locales. HSE separa la fiabilidad operativa del deber de mantener el equipo en condiciones seguras de trabajo. HSE, Maintenance of work equipment
NASA asocia su ejemplo numérico al supuesto de distribución exponencial y tasa relativamente constante en operación normal de un sistema maduro. Guía RCM de la NASA, §5.5.5.2 Si la tasa cambia con la edad, la carga o el entorno, ese ejemplo no sirve de pronóstico de la próxima avería.
NIST sitúa la mayor parte de la vida útil, con suerte, en la zona plana de la bañera, y también documenta mortalidad infantil y desgaste. NIST e-Handbook, §8.1.2.4
Siemens afirma que el MTBF no representa necesariamente la vida del producto y que, desde el número agregado, no se puede saber si la unidad fallida llevaba muchas horas o pocas. Manual Siemens 8US, §11 Esa limitación de catálogo vale igual para una media de planta.
HSE exige mantener el equipo de trabajo en estado eficiente, en buen orden y buen estado de reparación, y recuerda que fallos no diagnosticados añaden peligros. HSE, Maintenance of work equipment Un MTBF alto no prueba el cumplimiento de ese deber. Uno bajo tampoco autoriza improvisar el aislamiento o saltarse la competencia del personal. La orientación de HSE es del Reino Unido; en tu planta rigen las obligaciones locales aplicables.
Douglas Thomas plantea el valor económico del mantenimiento avanzado como problema de costes y pérdidas que exige datos (mantenimiento directo, paradas, ventas perdidas, retrabajo, defectos) y separación entre técnicas. NIST AMS 100-18 El MTBF puede entrar en el expediente. No cierra el caso de negocio ni el balance entre reactivo, preventivo y predictivo.
Límites explícitos de esta página:
- No uses el MTBF como fecha de caducidad de un activo concreto.
- No lo uses como certificado de seguridad.
- No compares cifras sin alinear población, horas, ventana y regla de fallo.
- No confundas MTBF con MTBM ni con disponibilidad.
- No sustituyas evidencia de un modo de fallo por el promedio del saco.
Leída como media observada con ficha, la cifra sigue siendo útil: ves si la exposición por fallo se mueve entre periodos comparables, detectas cambios de criterio en numerador o denominador, y abres el listado de eventos cuando la media y el suelo no coinciden. Ahí termina su autoridad.
Si necesitas decidir tarea por modo de fallo, vuelve a la matriz de predictivo, preventivo o correctivo. Si necesitas reconstruir una parada, usa evidencia con ventana y fuente. El MTBF resume; no investiga.
Preguntas frecuentes
¿El MTBF dice cada cuánto fallará este equipo?
No. El MTBF observado es una media de una población y una ventana declaradas; no fija la fecha de fallo de una unidad concreta. NIST estima el MTBF como tiempo total de operación entre fallos totales bajo el modelo de tasa constante. NIST e-Handbook, §8.4.5.1 Siemens añade que el número es indicación estadística y no necesariamente la vida del producto. Manual Siemens 8US, §11
¿Horas de calendario o de marcha?
Para leer fiabilidad operativa conviene usar horas de marcha (u otra exposición efectiva). Las horas de calendario miden otra pregunta. NASA y NIST construyen el estimador con horas de operación, no con el mero transcurso del mes. Guía RCM de la NASA NIST e-Handbook, §8.4.5.1
¿Un MTBF alto prueba que el activo es fiable o seguro?
No. Un MTBF alto resume un cociente observado; no acredita seguridad ni sustituye el mantenimiento competente del equipo. HSE vincula la seguridad al mantenimiento planificado y competente del equipo de trabajo, no a un promedio de fallos. HSE, Maintenance of work equipment NIST recuerda que la tasa puede no ser constante a lo largo de toda la vida. NIST e-Handbook, bañera
¿Qué debe acompañar a la cifra para poder interpretarla?
Como mínimo: población, ventana, tipo de horas y regla de qué cuenta como fallo, más el tratamiento de duplicados y exclusiones. NASA mantiene junto a su ejemplo las horas totales, el número de fallos y el supuesto de modelo. Guía RCM de la NASA, §5.5.5.2 Siemens ancla sus tablas a corriente, temperatura y método. Manual Siemens 8US, §11
¿Cuándo se pueden comparar dos cifras de MTBF?
Cuando población, exposición, ventana y regla de fallo son compatibles. Si alguno de esos campos difiere, la comparación queda abierta. Los intervalos de confianza de NIST muestran cuánto se ensancha la estimación con pocos fallos. NIST e-Handbook, §8.4.5.1 SAE JA1011 enmarca la gestión responsable de activos; no convierte dos cifras de MTBF huérfanas en benchmark. SAE JA1011_202411
¿WizeeMind calcula el MTBF oficial?
No. WizeeMind reúne evidencia operativa con fuente, hora y límite de activo; no calcula el MTBF oficial de la planta. Un MTBF oficial exige definiciones locales de población, horas, fallos y ventana, más la cadena de datos que las sostiene. NIST AMS 100-18 insiste en la necesidad de datos para estimar costes y pérdidas de mantenimiento; un panel externo no certifica el indicador. NIST AMS 100-18
Fuentes
- NASA: Reliability-Centered Maintenance Guide (PDF)
- NIST/SEMATECH e-Handbook: Constant repair rate (HPP/exponential) model
- NIST/SEMATECH e-Handbook: Bathtub curve
- NIST/SEMATECH e-Handbook: Repairable systems and lifetime models
- NIST AMS 100-18: Costs and Benefits of Advanced Maintenance in Manufacturing
- HSE: Maintenance of work equipment
- SAE JA1011_202411: Evaluation Criteria for RCM Processes
- Siemens: Power supply unit 8US2830-2BE01 Equipment Manual (MTBF / IEC 61709)